- AI / LLM
- Tự động hoá
- Công cụ nội bộ
AI Slack Check
Một mình đề xuất, xây dựng và vận hành pipeline Slack → rule tiếng Việt → Claude → PostgreSQL, thay việc HR đọc tay và nhập lại tin nhắn xin nghỉ, đi muộn, remote của ~50 nhân sự.
- Vai trò
- Full-stack · phát triển độc lập
- Team
- Một mình
- Thời gian
- 03/2026 – 04/2026
- Trạng thái
- Đã ngừng vận hành
~50
Nhân sự được xử lý
18
Lượt thu thập tự động mỗi ngày
~30
REST endpoint
32
Unit test
 Node.js
 Fastify
 TypeScript
 Claude API
 PostgreSQL
 React
Bối cảnh
Mỗi sáng, Slackbot đăng ba tin nhắn vào kênh điểm danh của công ty: OFF (nghỉ), LATE (đi muộn / về sớm) và REMOTE (làm từ xa). Nhân viên reply vào từng thread bằng tiếng Việt tự do — kèm @mention mentor, emoji và viết tắt: "Anh @Thuận em xin về sớm lúc 17h15 vì có việc gia đình ạ", "em đi muộn 15p kẹt xe", "em off chiều nay và ngày mai".
AI Slack Check là internal tool tôi tự đề xuất tại Protean Studios để biến những tin nhắn này thành dữ liệu chấm công có cấu trúc cho bộ phận HR.
Vấn đề
HR phải đọc tay từng thread mỗi ngày rồi nhập lại vào bảng chấm công:
- Tốn thời gian, dễ sai, khó tổng hợp theo tháng.
- Tin nhắn không có định dạng cố định: một câu có thể xin nghỉ nhiều ngày, nói thay cho nhiều người, hoặc lẫn giữa "về sớm" và "nghỉ".
- Không có cách truy ngược một con số trong báo cáo về tin nhắn gốc.
Vai trò của tôi
Tôi làm một mình toàn bộ: phân tích yêu cầu cùng HR, thiết kế hệ thống, backend Fastify + TypeScript, database PostgreSQL, viết prompt cho LLM, frontend React cho HR, test, deploy và vận hành production trên Vercel, Railway và Supabase.
Ràng buộc
- Ngôn ngữ tự nhiên tiếng Việt không theo mẫu, có dấu, viết tắt, emoji và markup của Slack.
- Sai một bản ghi là sai lương/phép → không thể tin tuyệt đối vào LLM; HR phải kiểm tra được.
- Dữ liệu thật lệch giả định: Slackbot không đăng đúng 7h sáng như thiết kế ban đầu (có lúc 12h50), reply có thể tới sau khi thread đã xử lý.
- Chi phí và hạ tầng nhỏ: Supabase free tier, Vercel Hobby, Railway Starter (~$5/tháng); proxy của Railway cắt request chạy lâu.
- Tên hiển thị Slack khác tên chính thức và có thể đổi bất kỳ lúc nào.
Kiến trúc
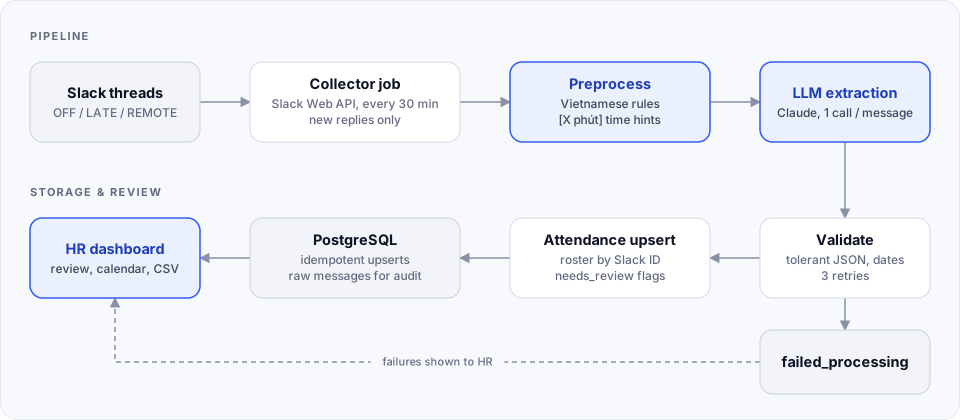
- Backend Fastify tổ chức theo layer:
SlackService → PreprocessService → LLMService → AttendanceService, điều phối bởiDailyCollectorJob; thêmRosterService,ReportService,CalendarService,AlertService. - Lịch chạy:
node-cronmỗi 30 phút từ 8h đến 16h30, thứ 2 – thứ 6 (18 lượt/ngày); HR kích hoạt tay một ngày, xử lý lại một ngày, hoặc sync theo khoảng ngày. - Database:
bot_messages(thread + trạng thái sync),raw_slack_data(tin nhắn gốc),attendance_logs(dữ liệu chấm công),employee_roster,failed_processing,hr_users. - Frontend React 7 trang trên Vercel;
vercel.jsonrewrite/api/*sang backend Railway để frontend gọi API cùng origin, không vướng CORS.
Quyết định kỹ thuật chính
Rule-based cho phần chắc chắn, LLM cho phần ngữ nghĩa
- Vấn đề: LLM tính sai số phút từ "về lúc 17h15", và tốn token cho cả những tin nhắn không phải yêu cầu.
- Lựa chọn: tiền xử lý tiếng Việt bằng rule trước khi gọi LLM:
- Làm sạch markup Slack (mention, URL, emoji code và emoji unicode,
<!here>…). - Lọc tin nhắn không phải yêu cầu: reminder của bot, câu xác nhận của quản lý, "ok em", "vâng", "thanks".
- Regex trích giờ về sớm (
lúc 17h15,về 5 chiều,5pm…) và quy đổiphút về sớm = 18:00 − giờ về; "1 tiếng rưỡi" → 90. - Gắn hint
[X phút]vào text gửi LLM: con số do regex tính, LLM chỉ lo phân loại.
- Làm sạch markup Slack (mention, URL, emoji code và emoji unicode,
- Lý do: phần tính toán cần kết quả chắc chắn; phần hiểu ý định mới cần LLM.
- Trade-off: phải bảo trì bộ regex tiếng Việt (ví dụ dùng
[^\d]*để khớp được chữ có dấu như "sớm").
Một tin nhắn, một lần gọi LLM
- Vấn đề: gửi cả thread trong một lần gọi, LLM trộn lý do và tên giữa các nhân viên.
- Lựa chọn: mỗi tin nhắn một lần gọi; map kết quả về người gửi theo Slack
ts(duy nhất, ổn định), fallback so tên đã bỏ dấu. - Trade-off: nhiều lần gọi hơn, chạy tuần tự nên chậm hơn — chấp nhận được với khối lượng một kênh và nhờ bước lọc nhiễu giảm số lần gọi.
Prompt riêng cho từng loại thread
- Lựa chọn: system prompt ngắn, cố định (luật bỏ qua, luật ngày tháng, thang confidence, chỉ trả JSON); user prompt riêng cho OFF / LATE / REMOTE với từ khoá, cây quyết định IF → THEN và few-shot examples kèm JSON đầu ra;
temperature = 0.1. - Xử lý ca khó: "về sớm" thuộc LATE chứ không phải OFF; nghỉ nhiều ngày ("off từ ngày 5 đến 9" → 5 bản ghi); một tin nhắn cho nhiều người; lý do chỉ lấy từ tin nhắn của chính người đó.
Output của LLM là dữ liệu không đáng tin
- Lựa chọn:
- Parser chịu lỗi: lấy được JSON trong code fence, JSON thuần và JSON bị cắt cụt (cắt tới dấu
}/]hợp lệ cuối cùng). - Validate từng field, giới hạn confidence trong [0, 1], chuẩn hoá ngày (
YYYY-MM-DD,D/M, "hôm nay", "ngày mai"), loại ngày không tồn tại (31/04), khử trùng lặp theo tên + ngày + buổi, bỏ kết quả confidence < 0.2. - Retry tối đa 3 lần cho mỗi tin nhắn khi API lỗi hoặc JSON không hợp lệ.
- Parser chịu lỗi: lấy được JSON trong code fence, JSON thuần và JSON bị cắt cụt (cắt tới dấu
Human-in-the-loop thay vì tự động 100%
- Lựa chọn: tự gắn cờ
needs_reviewkèm lý do khi confidence < 0.8, bản ghi LATE thiếu số phút, hoặc không tìm thấy nhân viên trong roster. Mỗi bản ghi trên dashboard mở được panel tin nhắn Slack gốc của đúng người đó; HR gỡ cờ từng bản ghi hoặc theo ngày, đánh dấu tin nhắn không hợp lệ. Lỗi xử lý thread và trường hợp "LLM trả rỗng dù có tin nhắn hợp lệ" ghi vàofailed_processingkèm gợi ý nguyên nhân. - Lý do: HR chịu trách nhiệm cuối cùng với dữ liệu chấm công; hệ thống chỉ cần đưa đúng những bản ghi đáng nghi lên trước.
Sync tăng dần và ghi idempotent
- Vấn đề: reply tới muộn bị bỏ sót; chạy lại không được tạo bản ghi trùng hay gọi lại LLM.
- Lựa chọn: nhận diện thread theo nội dung (không theo giờ đăng), quét khung 06:50–23:59; luôn đọc lại mọi thread và so
reply_tsvớilast_reply_tsđể chỉ xử lý reply mới; upsertattendance_logsvới khoá(employee_slack_id, date, type, duration)vàRETURNING (xmax = 0)để đếm thêm mới / cập nhật. Khoá códurationnên một người vẫn có thể vừa OFF buổi chiều vừa REMOTE buổi sáng.
Định danh bằng Slack ID, không bằng tên
- Lựa chọn:
employee_rosterlấyslack_idlàm khoá; đồng bộ thành viên kênh từ Slack (phân trang cursor, loại bot / tài khoản đã xoá), HR gán tên chuẩn hoặc import hàng loạt; tên tiếng Việt chuẩn hoá (Unicode NFD, bỏ dấu, lowercase). Sau khi gán, việc map nhân viên không phụ thuộc phán đoán của LLM.
SSE cho tác vụ dài sau proxy
- Vấn đề: sync 31 ngày bị proxy của Railway cắt do timeout.
- Lựa chọn: chạy 3 ngày song song (
Promise.allSettled, một ngày lỗi không hỏng cả lô) và stream tiến độ bằng Server-Sent Events (X-Accel-Buffering: no). Frontend đọc bằngfetch+ReadableStreamvìEventSourcekhông gửi được POST kèm header JWT.
Đánh đổi
- Gọi LLM tuần tự từng tin nhắn: đúng và dễ debug, đổi lại chậm hơn; hướng mở rộng là chạy song song có giới hạn, prompt caching hoặc batch API.
- node-cron trong process: đơn giản cho một instance, không phù hợp nếu scale ngang.
- SQL thuần với
pg, không ORM: kiểm soát truy vấn (COUNT(*) FILTER, upsert, partial index), đổi lại tự viết migration runner. - Tách interface
LLMProvider(Anthropic SDK / OpenAI-compatible) để đổi provider bằng biến môi trường — thêm một lớp trừu tượng nhỏ, đổi lại test được với proxy rẻ hơn mà không sửa code. - Một số giá trị còn cố định (giờ tan làm 18:00) — đủ cho một công ty, cần cấu hình nếu dùng rộng hơn.
Điểm nổi bật khi triển khai
- Slack: retry 3 lần với exponential backoff 1s–30s có jitter; bot tự
conversations.join; cache profile người dùng trong bộ nhớ (TTL 5 phút); parse @mention cả<@U123|Tên>và<@U123>và lưu thành danh sách mentor; sửa lỗi bỏ nhầm tin nhắn cha bằng điều kiệnthread_ts !== ts— phát hiện khi chạy thử với dữ liệu thật. - Hiệu năng: nạp roster một lần mỗi lượt chạy vào
Map(tra cứu O(1)) thay vì truy vấn cho từng bản ghi. - Báo cáo cho HR: tổng hợp tháng bằng
COUNT(*) FILTER (WHERE …); bảng chấm công dạng lịch (nhân viên × ngày, mỗi ô thể hiện cùng lúc OFF / LATE / REMOTE); top đi muộn, xu hướng 7 ngày; xuất CSV theo bộ lọc. Mọi bộ lọc dùng truy vấn có tham số. - Dashboard 7 trang: thống kê, biểu đồ Recharts, chi tiết hằng ngày có xem tin nhắn gốc, tổng hợp tháng, bảng chấm công, quản lý nhân viên đồng bộ từ Slack, danh sách lỗi;
FilterBardùng chung có debounce; API client typed. - Database: tự viết migration runner; schema tiến hoá qua 8 migration — thêm partial index
WHERE needs_review = TRUE, xoá bản ghi trùng rồi mới thêm unique constraint, chuyển bảngemployeescũ sangemployee_roster. - Vận hành: Docker multi-stage; Docker Compose 3 service cho local (postgres có healthcheck, tự chạy migration); kiểm tra DB + Slack lúc khởi động,
/api/health, graceful shutdown, log có cấu trúc bằng pino; auto-deploy từ GitHub qua 8 PR. - Test: 32 unit test (tiền xử lý 19, timezone 13) với fixture tin nhắn Slack thật.
Kết quả
- Chạy production trên Vercel, Railway và Supabase với chi phí hạ tầng khoảng $5/tháng.
- HR không còn đọc tay và nhập lại từng thread; báo cáo tháng theo nhân viên xuất bằng một click.
- Mọi bản ghi chấm công truy được về tin nhắn Slack gốc; bản ghi đáng nghi tự lên danh sách cần review.
- Ngừng vận hành từ 05/2026.
Bài học
- Chạy với dữ liệu thật càng sớm càng tốt: giờ đăng của bot, cấu trúc thread cha/con và reply đến muộn đều khác giả định ban đầu.
- Tách phần cần chính xác (tính phút, ngày tháng) cho rule, phần cần hiểu ngữ nghĩa cho LLM — vừa đúng hơn vừa rẻ hơn.
- Coi output của LLM như input từ người dùng: parse chịu lỗi, validate, chuẩn hoá và luôn giữ dữ liệu gốc để đối chiếu.
- Idempotency và khả năng xử lý lại (reprocess, sync khoảng ngày) phải có từ đầu với mọi pipeline chạy theo lịch.